
 Studio
在 H200 上自托管 GLM-5.3-Flash 写代码、GPT-6.1 Sol 负责规划的 OpenCode 配置实践
原标题:GLM-5.3-Flash on our H200s does most of my coding now while GPT-6.1 Sol orchestrates (OpenCode setup)
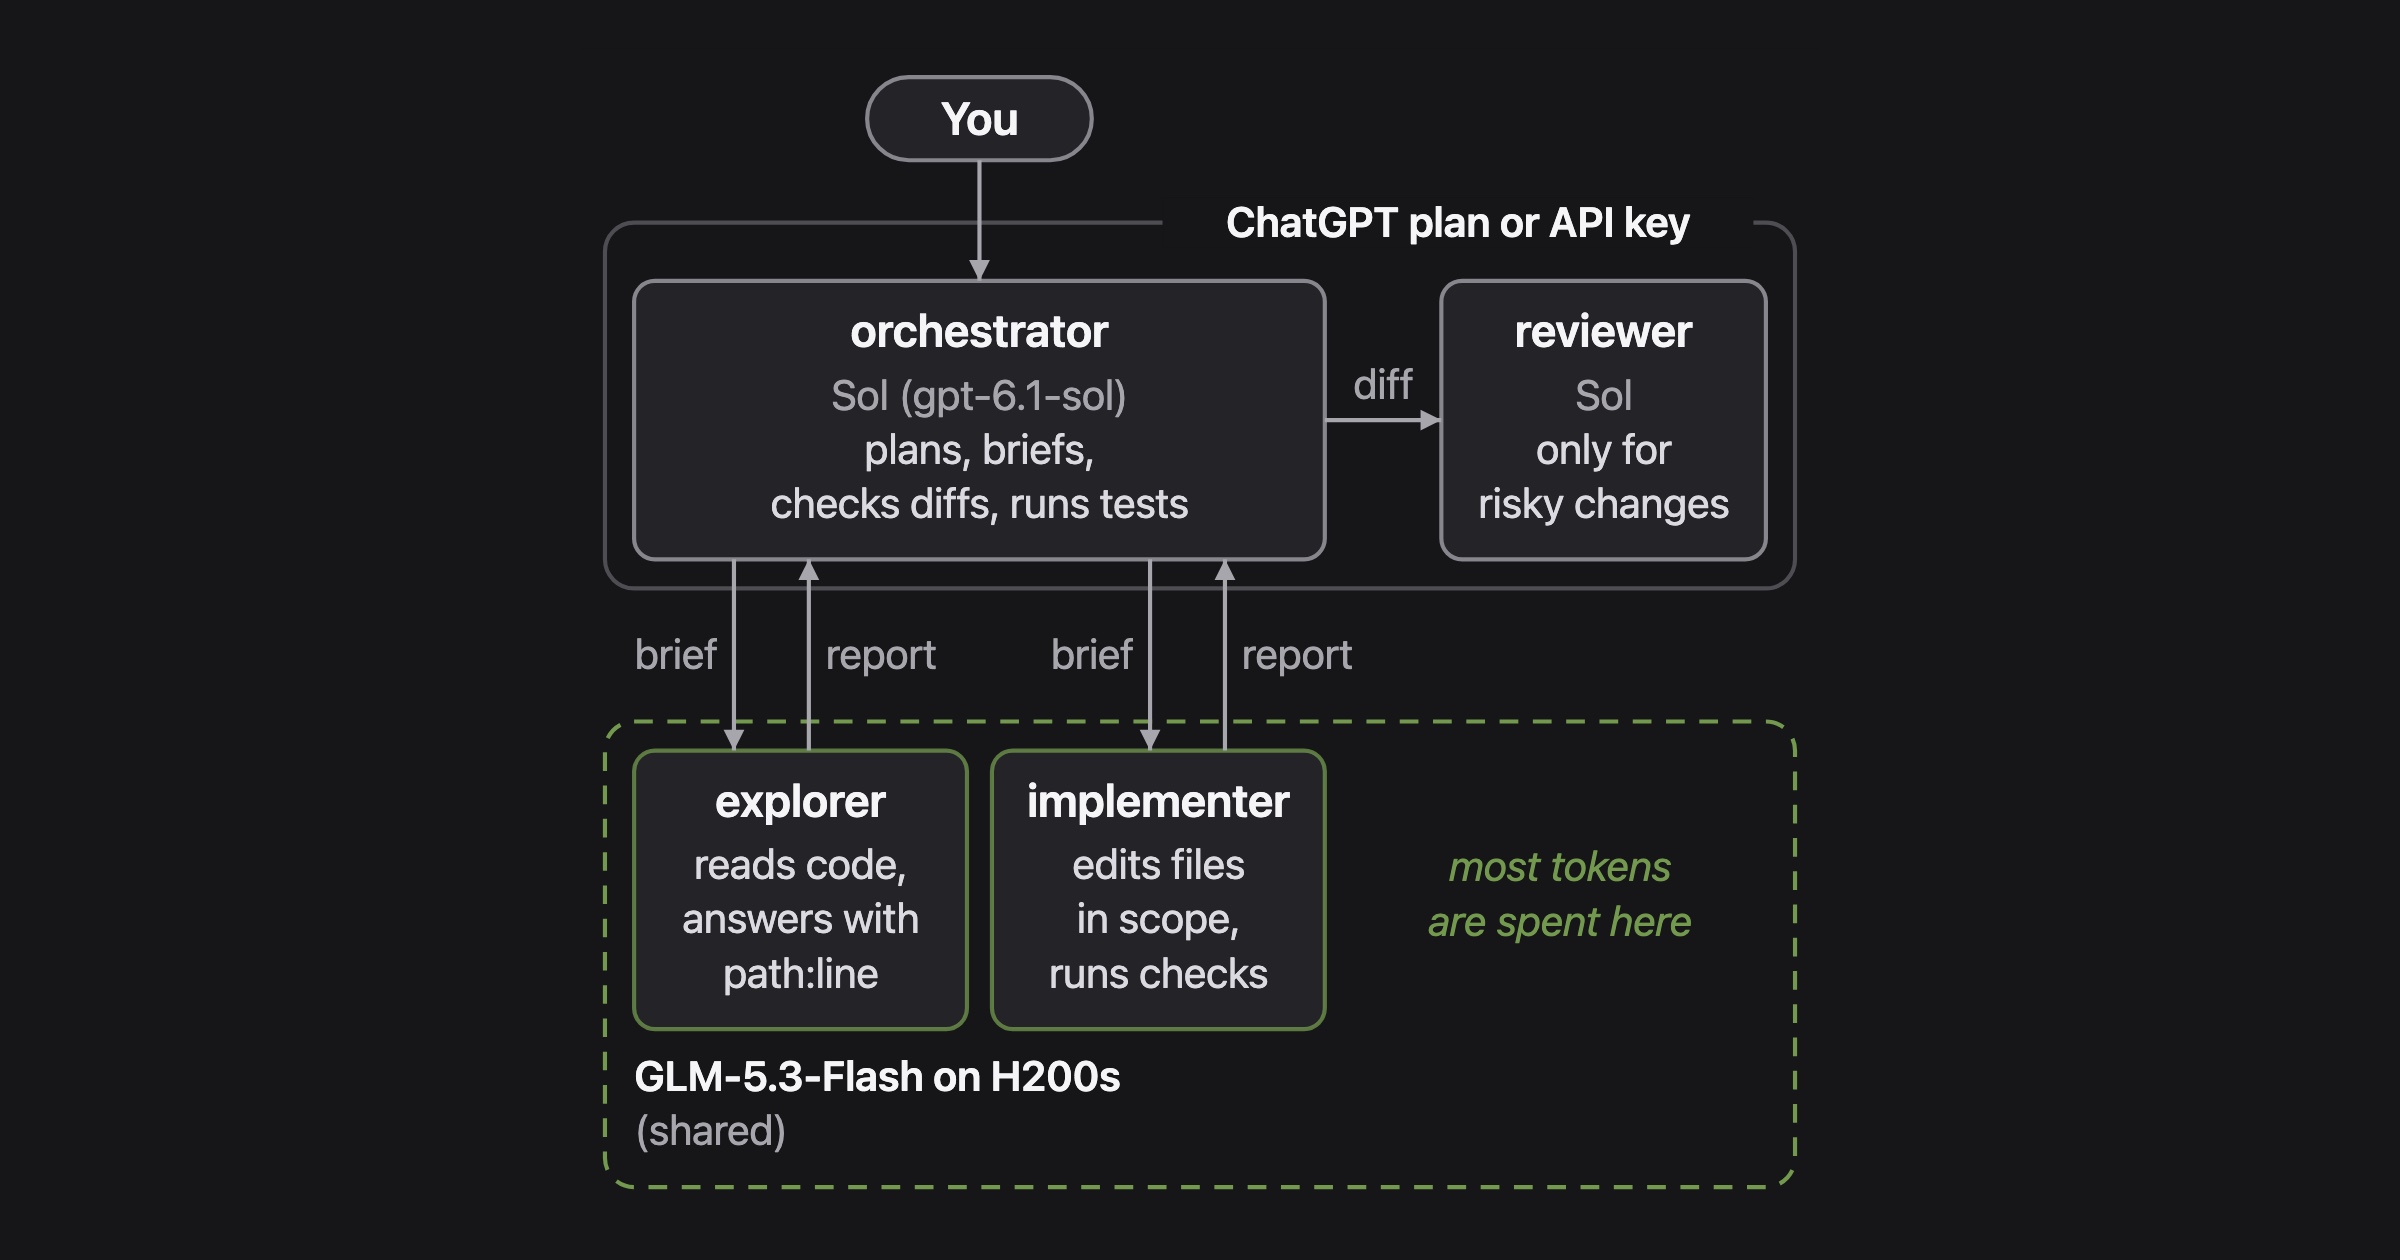
作者将 GLM-5.3-Flash(320B MoE,18B 激活)部署到公司 4 卡 H200 服务器,在 OpenCode 中搭配 GPT-6.1 Sol:Sol 负责规划、读 diff 和检查,GLM 负责读代码、改代码和跑测试迭代。Codex 和 Claude Code 无法让子智能体指向自定义端点,OpenCode 支持每个 agent 单独指定 provider/model,本地 provider 通过 @ai-sdk/openai-compatible 以 512K 上下文提供服务。作者关闭了内置 general 和 explore 子智能体,配置了 orchestrator、explorer、implementer、reviewer 等全局 agent,并提醒 OpenCode 不做沙箱需自行配权限规则。实测玩具任务中约 60% token 走 GLM,更大的实现任务约 …
为什么值得看
作者用自托管 GLM 干活、云端旗舰模型做规划的分工实测,给出了 OpenCode 配置、权限坑位和 token 占比数据,方法可直接迁移。
本页的摘要、推荐理由与解读出自 AIsa Studio 的 AI 风向智能体,原文版权归原作者所有。