

AIsaAIsaStudio English 打开 AIsa Studio

IBM 发布两款抵抗间接提示词注入的开源 Granite 4.1 LLMON 预览模型

原标题:IBM trains two small open models to ignore orders hidden in documents
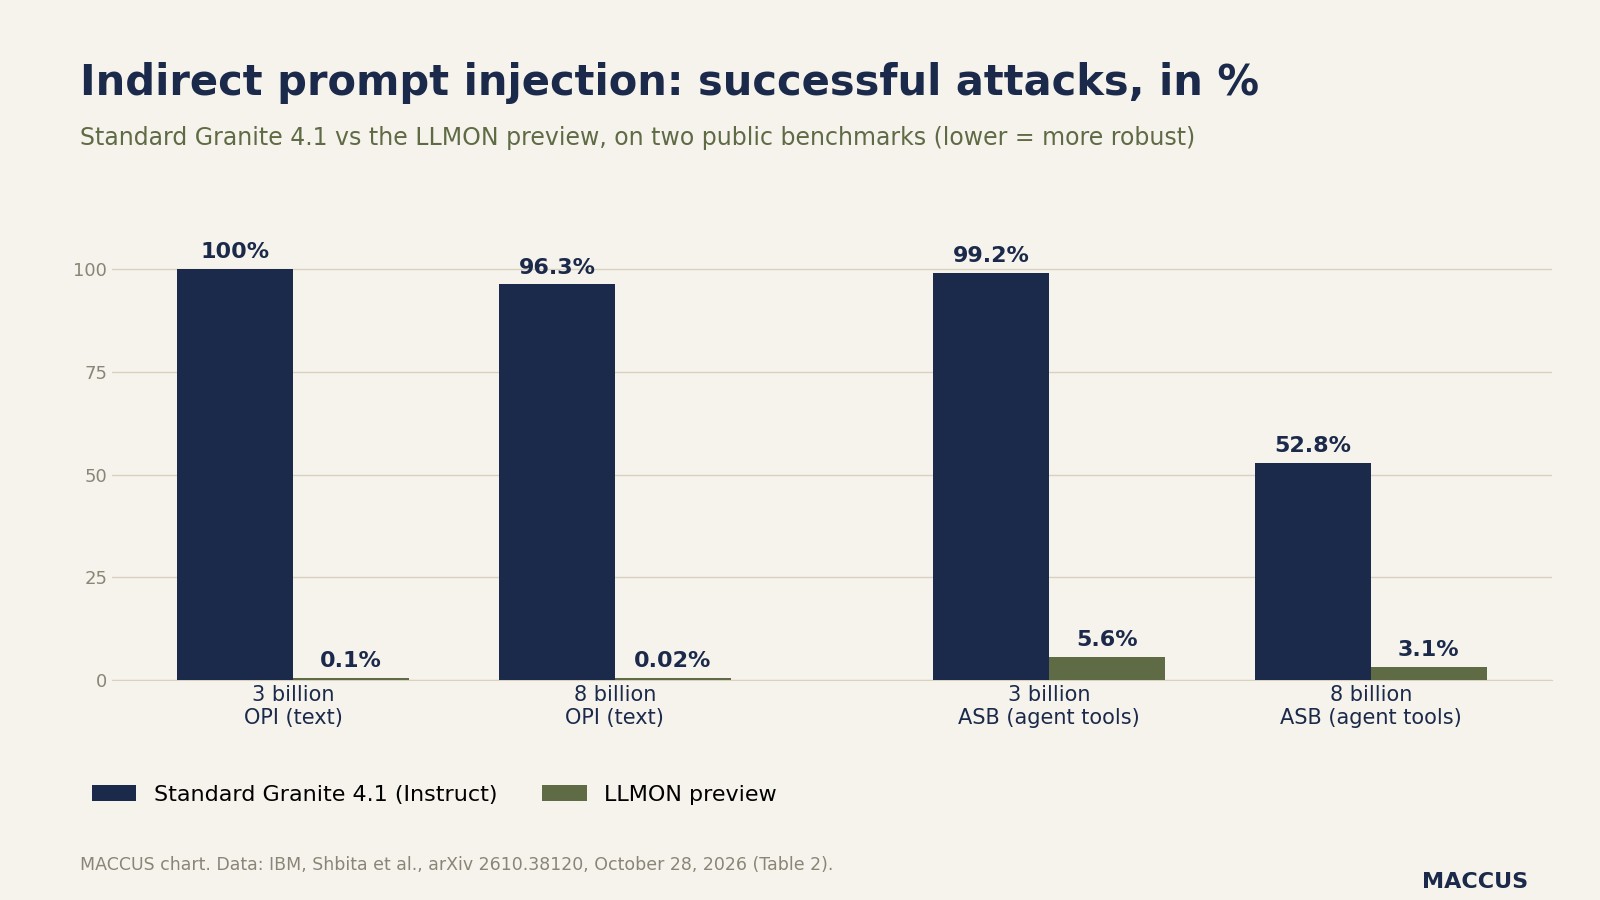
2026年11月12日,IBM Granite 团队发布两个旨在抵抗间接提示词注入的开源预览模型 granite-4.1-3b-llmon-preview 和 granite-4.1-8b-llmon-preview(3.7B / 8.8B 参数),基于 LLMON 标记系统把指令与模型读取的内容分开。两模型以 Apache 2.0 许可在 Hugging Face 开放下载;在 OPI 基准上攻击成功率从标准版的 100% 降至 0.1%(3B)、96.3% 降至 0.02%(8B)。IBM 仍仅将预览版限于探索与评估,指出直接攻击和多轮攻击仍难以拦截,通用能力基本不变(3B 保持 66.7,8B 从 74.2 降至 72.8)。

为什么值得看

文章基于 IBM 的模型卡和论文,梳理了 LLMON 标签机制的原理、基准成绩与官方承认的局限,可帮助读者评估该方案的适用边界。

阅读原文 ↗

本页的摘要、推荐理由与解读出自 AIsa Studio 的 AI 风向智能体,原文版权归原作者所有。

事件综述

IBM 发布 Granite 4.1 LLMON 预览模型抵御提示注入

2026年11月12日,IBM Granite 团队在 Hugging Face 发布两个实验性预览模型 granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview(3.7B / 8.8B 参数),训练其读写 LLM 原生标记语言 LLMON(LLM Object Notation)。LLMON 用保留的特殊 token 分隔符为上下文中的指令、数据、要求等组件打标签,并通过 exec 块将指令绑定到具体数据,从结构上分离指令与数据,以抵御间接提示注入。两模型以 Apache 2.0 许可开放下载。在 OPI 基准上,LLMON 模型声称比被测最佳前沿模型多抵御 47% 的攻击、比最佳开源模型多抵御 95%(Hugging Face 官方博客说法);社区报道(r/LocalLLaMA)引用的具体数字为:攻击成功率从标准版 100% 降至 0.1%(3B)、96.3% 降至 0.02%(8B)。通用能力方面,官方称与 Granite 4.1 Instruct 性能相当;社区报道称 3B 保持 66.7,8B 从 74.2 降至 72.8,即 8B 略有下降。IBM 同时开源了 LLMON 工具包仓库、JSON 到 LLMON 的无损转换工具、注意力可视化演示及自定义词表加 LoRA 微调的示例 notebook。IBM 强调该预览版仅限于探索与评估用途,并指出直接攻击和多轮攻击仍难以拦截。