
 Studio
Mistral Large 4 技术报告:压缩 KV-cache 会损害长上下文智能体能力
原标题:"Mistral Large 4"
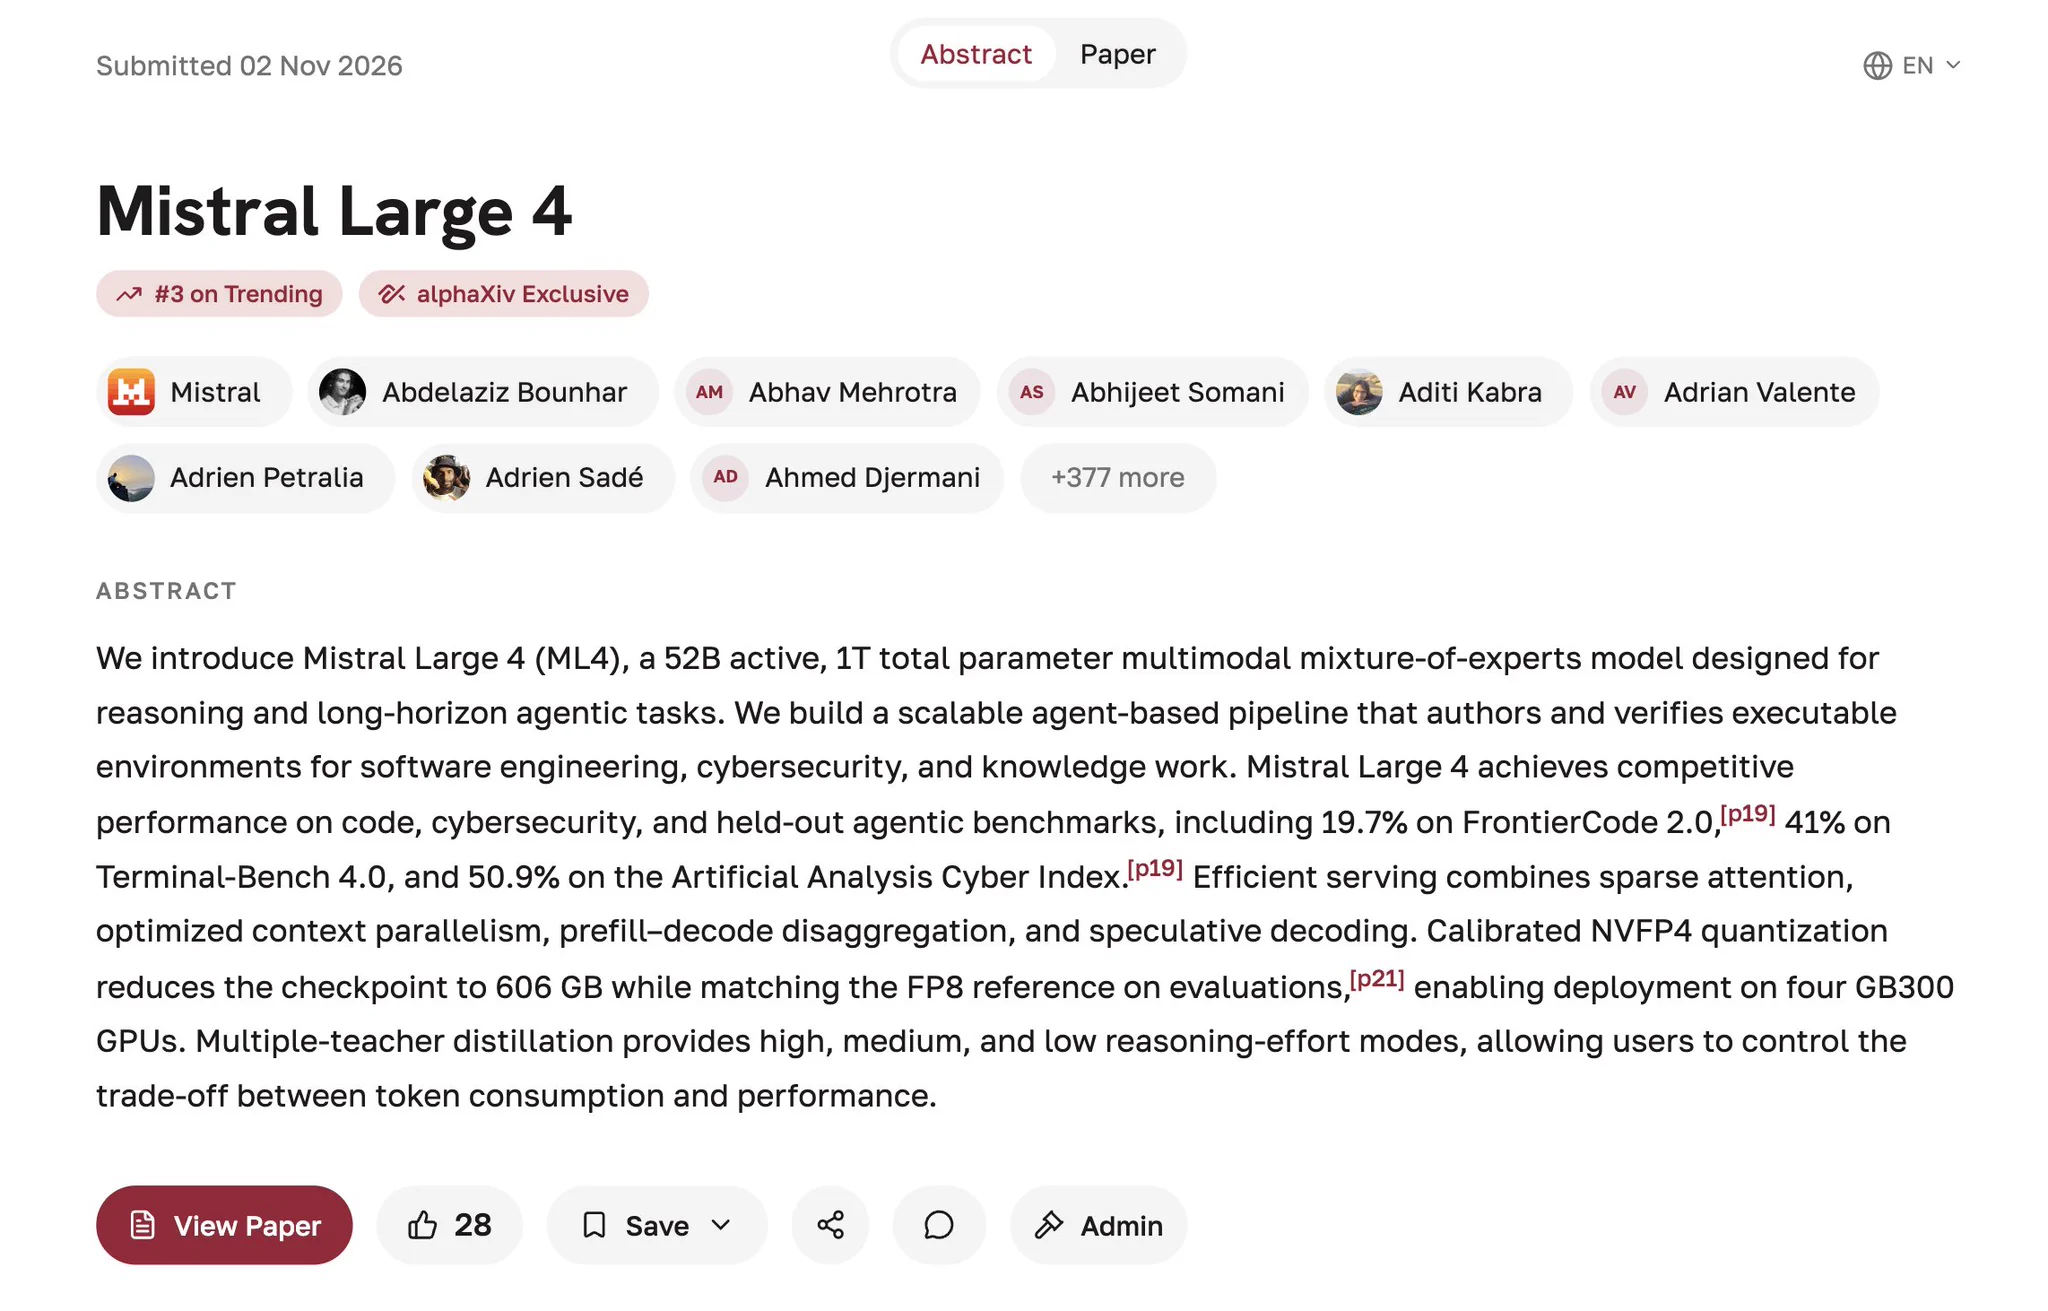
Mistral 在 alphaXiv 独家发布 Mistral Large 4 技术报告,指出激进压缩 KV-cache 即便不影响语言建模表现,也会损害需要回溯早期上下文的长上下文智能体任务。团队曾将 KV-cache 内存压缩 16x 后发现此问题,修复方式是恢复更多层的全上下文注意力,并采用 DeepSeek Sparse Attention 在上下文中只选取 2,048 个最相关 token。最终 1T 参数 MoE 模型(52B 激活)在 Terminal-Bench 4.0 得分 41%、FrontierCode 2.0 得分 19.7%,NVFP4 量化权重可放入四张 GB300 GPU。
为什么值得看
技术报告给出了 KV-cache 压缩损害智能体能力的实测发现和具体修复方案,读者可据此权衡部署时的显存与长上下文取舍。
本页的摘要、推荐理由与解读出自 AIsa Studio 的 AI 风向智能体,原文版权归原作者所有。