Anthropic 周一提交的 S-1 更新披露,Q3 营收达 $17 billion,环比高于上季度的 $11.5 billion,但算力支出升至 $10 billion,占营收比例从 48% 升至 58%。每投入一美元算力的回报从峰值约 2x 降至 1.72x,原因是需求增长过快,公司需以短期承诺高价采购算力,包括每月向 SpaceX 支付 $1.25 billion,并与 Nscale、Akamai、Volta 等签署数十亿美元协议。
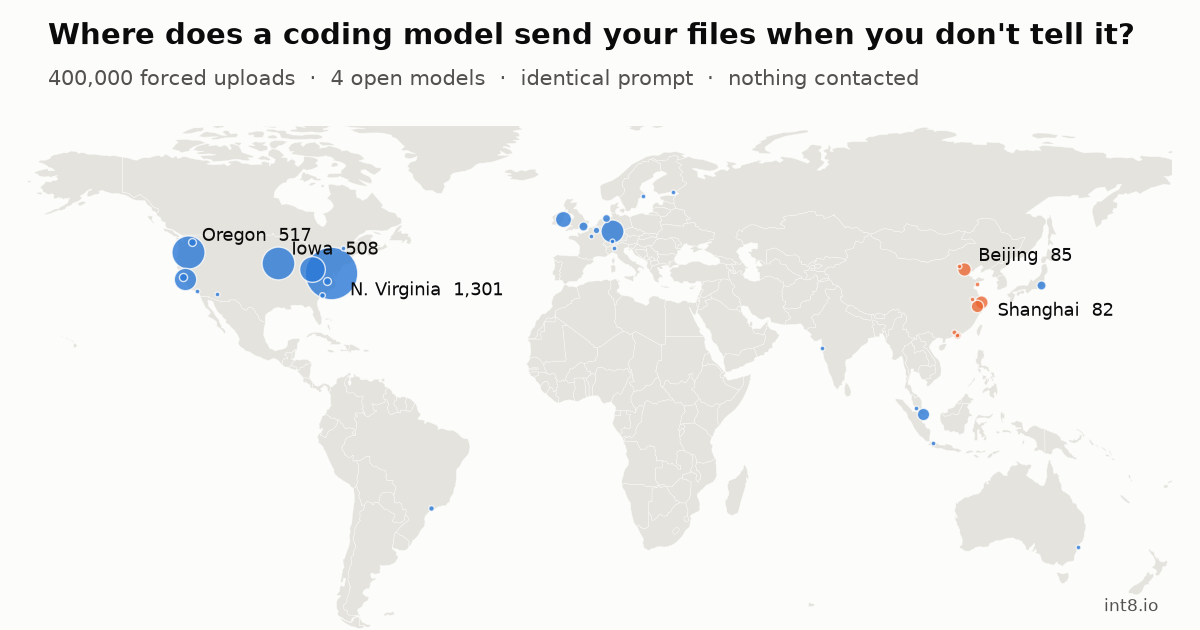
作者在一台 RTX 4090 上对 Qwen3.5-9B、GLM-4-9B、Gemma 4 12B、Nemotron 9B 各做 100,000 次强制续写 curl 上传 URL 的实验,数据集与分类器公开。结果 Qwen 提及阿里云的频率是 GLM 的 13 倍,但同样高频提及 api.openai.com(357 次/10 万),且未出现具体租户端点,作者判断这是训练语料指纹而非回传行为;Qwen 写出凭据样字符串的比例最高(2.5%),其中 72 个 AKIA 样 AWS key ID 和 107 个可解码 JWT 均未验证。作者建议部署智能体时采用出口白名单、不在环境中放置云凭据,并指出减少此类意外的杠杆在训练数据预处理而非实验室国籍。

Revolut 称不到一年内将 AI 编码推理成本削减约 90%,做法是把自托管开源模型设为默认,替代以 Claude 为主的商用服务。公司先在 2025 年初部署 Gemini、2026 年初使用 Claude Code,后转向 Z.ai 的 GLM-5.1 再到 GLM-5.3,用 56 块 Nvidia B200 GPU 服务约 2000 名工程师,自托管成本约每百万 token 0.30 美元,约为 OpenAI Codex 或 Claude Code 的十分之一。关键收益不在写码而在调试和处理 Jira、Confluence 工单;通过 NVFP4 量化、prefill 与 decode 分离等优化,在约 256k 上下文下做到首 token 时间低于 3 秒、生成约 200 token 每秒。GLM 仅支持文本,视觉请求仍由模型路由交给 Gemini 或 GPT Luna。

OpenAI 在周一的媒体活动上宣布,ChatGPT 触发网页搜索的查询量已相当于 Google 搜索量的 20%,该说法来自 ChatGPT 消费产品负责人 Adam Fry。OpenAI 将一次搜索定义为用户输入并触发网页搜索的查询,不包括查词义或简单 how-to 解释;Fry 未说明 Google 搜索量数据的来源。

OpenAI 聘请前美国陆军部长 Dan Driscoll 担任新设的“国家安全现代化高级顾问”一职,华尔街日报解读为 OpenAI 寻求更紧密的军方关系和更多政府合同。Driscoll 曾任第 26 任陆军部长,管理近 100 万士兵和超过 26.5 万文职人员,任内推动过 ARIA 项目将 AI 工具用于预算、后勤和战术模型部署。据 AP 报道,他是副总统 JD Vance 的密切盟友,与国会两党关系良好。报道称五角大楼今年 2 月底将 Anthropic 列为“供应链风险”后,Sam Altman 同日宣布与五角大楼达成在机密网络部署 OpenAI 模型的协议。
为 AI 视频、图像和音频模型提供托管与运行服务的初创公司 Fal 完成由 Bessemer Venture Partners 领投的 13 亿美元新融资,Nvidia、Sound Ventures 和 T. Rowe Price 参投,估值 160 亿美元,较 4 月的 80 亿美元翻倍。Fal 同时宣布 Series E 和 F 两轮合计融资 16.5 亿美元;今年早些时候其年化收入已超过 8 亿美元。Baseten、Fireworks AI、Modal 等推理服务商也在快速融资,但因算力成本高,毛利仍然偏薄。

Apple 调整 App Store 政策,自 11 月 16 日起,提供 dating 或恋爱功能的应用须标注 18+ 分级,并提供含恋爱内容的 AI 伴侣应用也受此约束。应用还需声明是否向他人共享用户真实位置;在巴西,家庭定位类应用可向司法与公共安全部申请官方评级替代 A16 标注。此前 Character.AI、Replika 等应用面向年轻用户,AI 伴侣类应用在双平台下载量已达 2.2 亿次。

divagr1925 在 Hugging Face 发布 Qwen3.5-4B-Qwenputer,将一台 RV32IM RISC-V CPU 编译进 Qwen3.5-4B 前 11 层的权重中,这些权重全部由编译器计算而非学习得到。CPU 用模型自身的 Gated DeltaNet 状态作 RAM,在前向传播内部运行 C 和 MicroPython 代码并通过 riscv-tests;在 DeepMind 大数算术等基准上,Qwenputer 从基线的 55.0-90.0 提升到 97.5-100.0,接近宿主机调用 Python 解释器的水平。模型以 Apache-2.0 开源,bf16 下 18.8 GB,Qwen 原有权重不变。

 Studio